ทำไม AI agent ถึงพังตอนปล่อยให้รันเอง: บังเหียนที่ต้องมีก่อนไว้ใจมัน
ตอนเราทำ workshop สอนให้ Claude เรียกฟังก์ชันในเครื่องเมื่อกลางเดือนนี้ สคริปต์ตัวอย่างรันผ่านสวยงามสี่ขั้นติด พอถึงคำถามที่ต้องเปิดสองไฟล์เทียบกัน มันพังทันทีด้วย error 400 ทั้งที่โค้ดไม่มีบรรทัดไหนผิด เหตุผลคือโมเดลขอเรียกเครื่องมือสองครั้งในเทิร์นเดียว แต่โค้ดที่เราเขียนไว้ตอบกลับได้ทีละหนึ่ง สิ่งที่พังไม่ใช่โมเดล แต่คือโครงที่เราสร้างล้อมมันไว้แคบเกินกว่าที่มันจะทำงานได้จริง ลองขยายภาพนั้นให้ใหญ่ขึ้นเป็นระบบที่ปล่อยรันข้ามคืนโดยไม่มีคนนั่งดู แล้วคุณจะเห็นว่าทำไม agent ถึงพังกันมากขนาดนี้
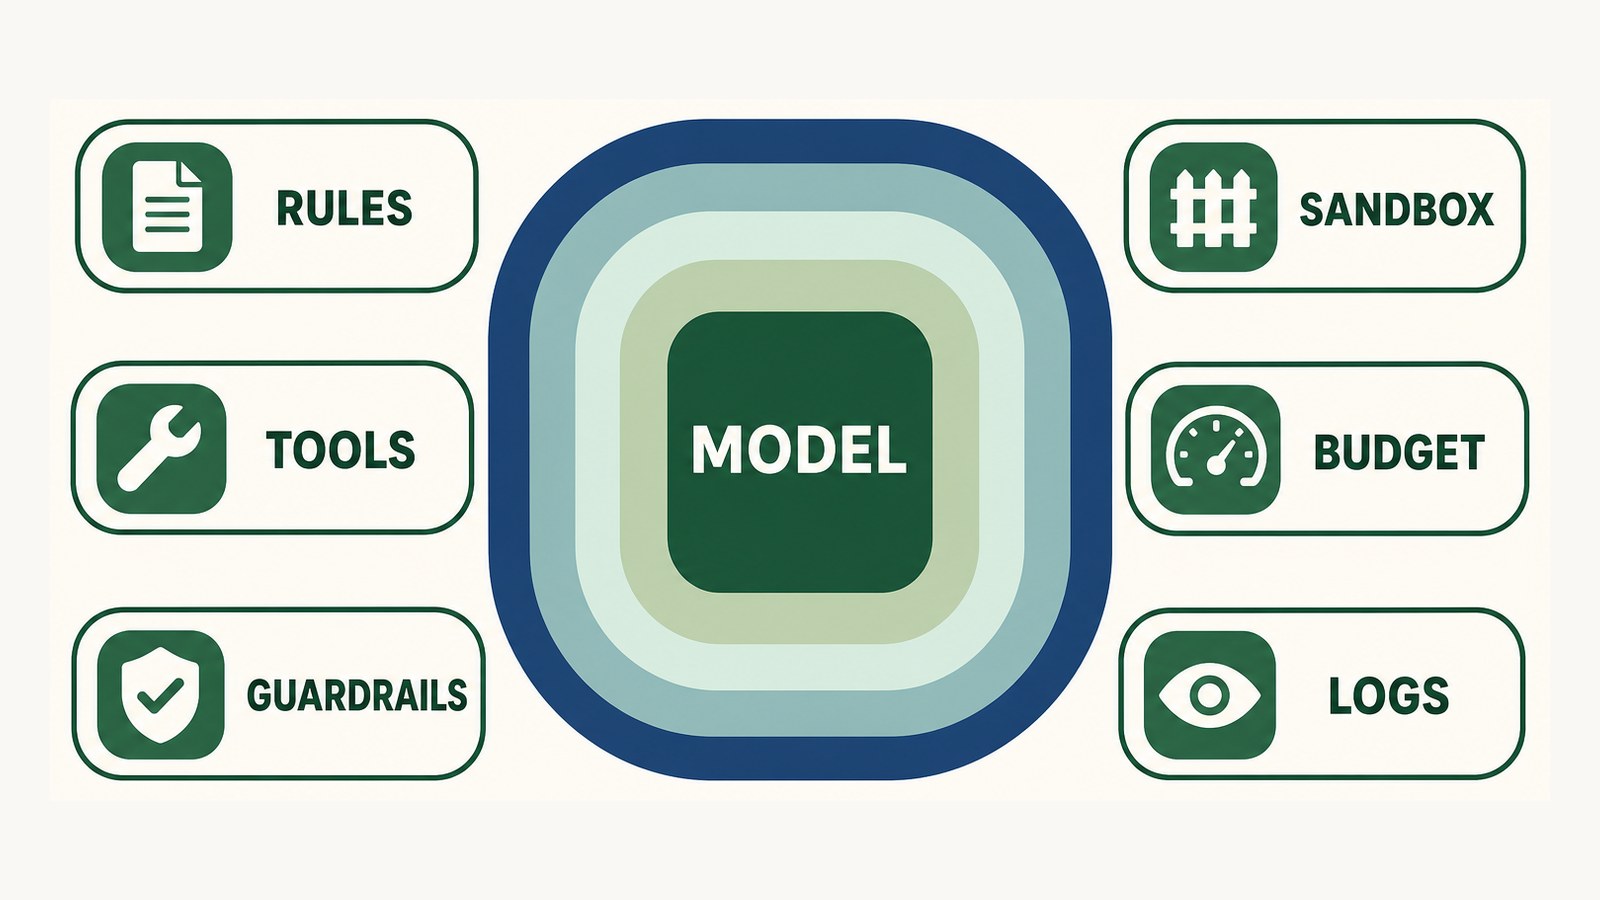
สรุปสั้น ๆ: agent ที่เชื่อถือได้กับไม่ได้ ต่างกันที่ “ทุกอย่างที่ไม่ใช่โมเดล” ไม่ใช่ที่ตัวโมเดล ฝั่งโมเดลเราเช่ามาและควบคุมข้างในไม่ได้ ส่วนฝั่งที่เหลือ (คำสั่งถาวร เครื่องมือ สนามที่ให้วิ่ง สิทธิ์ที่ให้ถือ การจัดการ context เพดานงบ และระบบมองเห็น) คือส่วนที่เราออกแบบได้ทั้งหมด และเป็นตัวตัดสินว่าปล่อยมันรันเองได้หรือยัง
ปัญหาไม่ได้อยู่ที่โมเดล แต่อยู่ที่ทุกอย่างรอบตัวมัน
คำตอบตรง ๆ ก่อน: เวลา agent พังในงานจริง สาเหตุส่วนใหญ่เป็นเรื่องสถาปัตยกรรมรอบโมเดล ไม่ใช่ความฉลาดของโมเดล การเปลี่ยนไปใช้รุ่นใหม่กว่าจึงมักไม่ช่วย ถ้าโครงรอบ ๆ ยังหลวมเหมือนเดิม
วงการเริ่มเรียกโครงรอบ ๆ นั้นว่า harness (บังเหียน) และสรุปเป็นสมการสั้น ๆ ว่า agent = โมเดล + บังเหียน ทีม LangChain เขียนประโยคที่จำง่ายที่สุดไว้ว่า ถ้าคุณไม่ใช่โมเดล คุณก็คือ harness แปลเป็นภาษาทำงานคือ ทุกบรรทัดของโค้ด ทุกไฟล์ตั้งค่า ทุกกติกาที่อยู่รอบการเรียกโมเดล นับเป็นบังเหียนทั้งหมด
ความต่างของสองฝั่งนี้สำคัญมากเวลาตัดสินใจว่าจะลงแรงตรงไหน
- ฝั่งโมเดล เลือกได้ เปลี่ยนได้ แต่ควบคุมข้างในไม่ได้เลย และทุกบริษัทเข้าถึงได้เท่ากันผ่าน API เดียวกัน
- ฝั่งบังเหียน ออกแบบได้ ทดสอบได้ แก้ได้ และเป็นของเฉพาะงานของคุณ ไม่มีใครขายสำเร็จรูปแทนได้
เวลาที่คนบ่นว่า agent ไม่ฉลาดพอ ในความเป็นจริงมักเป็นสถานการณ์ที่มันไม่มีทางรู้ เช่น ไม่รู้ว่าโปรเจกต์นี้ใช้คำสั่งเทสตัวไหน หรือไม่รู้ว่าไฟล์ไหนห้ามแตะ ข้อมูลพวกนี้ไม่ได้อยู่ในโมเดล แต่อยู่ในหัวคุณ และหน้าที่ของบังเหียนคือย้ายมันออกมาอยู่ในระบบอย่างถาวร ถ้ายังไม่คุ้นว่า agent หมุนวงจรคิดแล้วลงมือยังไง บทความเรื่องกลไกของ agent ปูพื้นส่วนนั้นไว้แล้ว
ทำไมเดโมผ่านฉลุย แต่ของจริงพัง
เหตุผลข้อแรกเป็นคณิตศาสตร์ล้วน ๆ: ความผิดพลาดในงานหลายขั้นมันทบต้น ถ้าแต่ละก้าวถูก 90% งานที่มีสิบก้าวจะถูกทั้งสายเหลือราว 35% เดโมมักเป็นงานสองสามก้าวในสภาพแวดล้อมที่จัดฉากไว้ดี ส่วนงานจริงยาวกว่านั้นหลายเท่าและมีของไม่คาดฝันเต็มไปหมด
เหตุผลข้อสองน่าสนใจกว่า: ทีมส่วนใหญ่ “เห็น” ว่า agent พัง แต่ไม่ได้ “วัด” ว่ามันพังแบบไหน รายงาน State of Agent Engineering ของ LangChain (สำรวจ 1,340 คน ปลายปี 2025) พบว่า 57% ขององค์กรมี agent รันใน production แล้ว และอุปสรรคอันดับหนึ่งที่คนราวหนึ่งในสามพูดถึงคือคุณภาพ ไม่ใช่ราคา ที่น่าคิดคือช่องว่างในรายงานฉบับเดียวกัน: ราว 89% ติดตั้งระบบ observability ไว้แล้ว แต่มีแค่ 52% ที่รัน evaluation แบบออฟไลน์ และ 37% ที่วัดแบบออนไลน์
พูดอีกแบบคือ เกือบทุกทีมมีกล้องวงจรปิด แต่ครึ่งหนึ่งไม่เคยดูเทปอย่างเป็นระบบ พอถามว่า agent เวอร์ชันใหม่ดีกว่าเดิมจริงไหม เลยตอบได้แค่ความรู้สึก
เหตุผลข้อสามคือ ยิ่งปี 2026 คนปล่อยให้ agent ทำงานยาวขึ้นโดยไม่นั่งเฝ้า ระยะห่างระหว่างคนกับงานก็ยิ่งกว้าง ความผิดพลาดที่เมื่อก่อนคนเห็นใน 30 วินาทีแล้วกดหยุดทัน ตอนนี้กลายเป็นความผิดพลาดที่ถูกค้นพบตอนเช้าวันรุ่งขึ้น พร้อมบิลค่า token และงานที่ต้องรื้อ
ชั้นที่ถูกที่สุดและได้ผลไวที่สุด: คำสั่งถาวรกับการออกแบบเครื่องมือ
ถ้ามีเวลาแค่หนึ่งบ่าย ให้ลงแรงสองชั้นนี้ก่อน เพราะมันถูกที่สุดและเห็นผลเร็วที่สุด
ชั้นแรกคือ คำสั่งถาวร ไฟล์เดียวที่ agent อ่านทุกครั้งก่อนเริ่มงาน (หลายทีมตั้งชื่อว่า AGENTS.md) กติกาที่ใช้ได้ผลจริงคือ อย่านั่งเขียนกฎร้อยข้อล่วงหน้าจากจินตนาการ แต่ให้เพิ่มกฎ เฉพาะตอนที่ agent ทำพลาดจริง หนึ่งความผิดพลาดแลกหนึ่งบรรทัด ไฟล์แบบนี้จะค่อย ๆ กลายเป็นแผลเป็นที่เปลี่ยนเป็นภูมิคุ้มกัน ต่างจากไฟล์ที่ก๊อปเทมเพลตมาวันแรกแล้วไม่เคยแตะอีก ซึ่งมักยาวจนกลายเป็นเสียงรบกวนที่โมเดลเลือกจะข้าม
ชั้นที่สองคือ การออกแบบเครื่องมือ จุดที่คนมองข้ามบ่อยสุดคือ ข้อความอธิบายเครื่องมือและข้อความ error ที่มันได้รับกลับ ล้วนเป็น prompt ที่คุณเขียนโดยไม่รู้ตัว ทั้งคู่ไหลเข้า context ตรง ๆ หลักง่าย ๆ ที่ใช้ได้กับทุกเครื่องมือ
- ทำ schema ให้แคบที่สุดเท่าที่งานต้องการ ช่องที่ไม่มีก็คือช่องที่กรอกผิดไม่ได้ นี่คือบังเหียนที่ได้มาฟรี
- ข้อความ error ต้องบอกว่าควรทำอะไรต่อ ไม่ใช่โยน stack trace ใส่แล้วปล่อยให้มันเดา
- คิดเป็นระดับงาน ไม่ใช่ระดับ API เครื่องมือหนึ่งชิ้นควรจบหนึ่งความตั้งใจ ไม่ใช่บังคับให้ agent ต่อจิ๊กซอว์เองห้าครั้ง
- เผื่อไว้เสมอว่ามันจะขอใช้หลายเครื่องมือในเทิร์นเดียว นี่คือจุดที่สคริปต์ใน workshop tool use ของเรา พังด้วย error 400 และเป็นบทเรียนที่ราคาถูกมากถ้าได้เจอตอนเขียนโค้ดสิบบรรทัด แทนที่จะเจอตอนรันจริง
ชั้นที่ทำให้ “พังแล้วไม่เจ็บ”: สนาม สิทธิ์ และประตูอนุมัติ
สองชั้นแรกลดโอกาสพลาด แต่ไม่มีวันลดเหลือศูนย์ ชั้นถัดไปจึงไม่ได้ถามว่าจะกันไม่ให้พลาดยังไง แต่ถามว่า ถ้าพลาดแรงที่สุด ความเสียหายไปได้ไกลแค่ไหน
เคสที่ชัดที่สุดของปีนี้คือเหตุการณ์ที่ PocketOS บริษัทที่ดูแลข้อมูลการจองรถเช่าในสหรัฐ เมื่อ 25 เมษายน 2026 agent เขียนโค้ดตัวหนึ่งลบฐานข้อมูล production พร้อมแบ็กอัปภายในเวลาเก้าวินาที ผู้ก่อตั้งต้องนั่งประกอบข้อมูลการจองขึ้นใหม่จากรายการจ่ายเงินและอีเมลยืนยันตลอดสุดสัปดาห์ สิ่งที่ควรจำไม่ใช่ความน่ากลัวของ AI แต่เป็นรายการสาเหตุ: token ที่สร้างไว้ทำงานเล็ก ๆ อย่างเดียวแต่ดันถือสิทธิ์ลบ volume ติดมาด้วย, แบ็กอัปถูกเก็บอยู่ในที่เดียวกับของจริง, คำสั่งที่เขียนห้ามไว้เป็นตัวอักษรกันอะไรไม่ได้เลยเมื่อระบบข้างล่างอนุญาต
บทเรียนจึงตรงไปตรงมา ให้แปลคำว่า “ห้าม” จากประโยคในไฟล์คำสั่ง มาเป็นกลไกที่ฝ่าฝืนไม่ได้จริง
- สนามแยก (sandbox) ให้ agent วิ่งในพื้นที่ที่พังแล้วซ่อมได้ ไม่ใช่โฟลเดอร์เดียวกับของจริง
- สิทธิ์เท่าที่งานต้องใช้ ออก credential ของ agent แยกต่างหาก ขอบเขตแคบเท่างานตรงหน้า ไม่ใช่หยิบ token ที่เปิดได้ทุกประตูมาใช้เพราะมันอยู่ใกล้มือ
- ประตูอนุมัติสำหรับสิ่งที่ย้อนกลับไม่ได้ ลบข้อมูล จ่ายเงิน ส่งอีเมลหาลูกค้า แตะ production ควรต้องมีคนกดยืนยัน
- แยกสภาพแวดล้อมให้ขาด เครื่อง dev ไม่ควรเอื้อมถึง production ได้ตั้งแต่แรก
จุดที่คนมักเข้าใจผิดคือคิดว่าชั้นนี้มีไว้กด agent ไม่ให้ทำอะไรได้มาก กลับกันเลย ทีมที่กล้าปล่อยให้ agent ทำงานใหญ่คือทีมที่มีบังเหียนแน่นพอจะกล้า ขอบเขตที่ชัดไม่ใช่โซ่ตรวน แต่คือใบอนุญาตให้อิสระ
ชั้นที่ทำให้รันยาวได้: context งบ และจุดหยุด
พอ agent ทำงานนานขึ้น ปัญหาจะเปลี่ยนหน้าไปเป็นอีกแบบ ไม่ใช่ทำผิดคำสั่ง แต่ ค่อย ๆ ลืมว่ากำลังทำอะไรอยู่ เพราะทุก tool call ทุกไฟล์ที่อ่าน สะสมอยู่ใน context จนพื้นที่สำหรับคิดงานจริงเหลือน้อยลงเรื่อย ๆ
ประเด็นที่เราพิสูจน์ด้วยตัวเองใน workshop เรื่องเอกสารยาว คือ context ไม่ใช่ถังที่ยัดอะไรลงไปก็ได้ เอกสารชุดเดียวกัน คำถามเดียวกัน เปลี่ยนแค่ลำดับว่าวางคำถามไว้ก่อนหรือหลังเนื้อเอกสาร ผลลัพธ์ต่างกันจากตอบว่าไม่พบข้อมูล กลายเป็นตอบถูก การจัดระเบียบสิ่งที่โมเดลเห็นจึงเป็นงานวิศวกรรม ไม่ใช่รายละเอียดปลีกย่อย
สำหรับงานที่รันยาวจริง ๆ แนวปฏิบัติปี 2026 ขยับไปไกลกว่าการย่อประวัติการสนทนา (compaction) แล้ว เพราะการย่อซ้ำ ๆ ทำให้รายละเอียดสำคัญหลุดหายไปเงียบ ๆ วิธีที่ทีมที่รัน agent ข้ามวันใช้กันคือเขียนสถานะสำคัญลงที่ที่ทนทานกว่าบทสนทนา เช่นไฟล์สรุปงานหรือ commit แล้วเริ่ม session ใหม่จากไฟล์นั้นแทนการลากประวัติเดิมไปทั้งก้อน หลักคือบันทึกสถานะทุก ๆ ไม่กี่ก้าว ไม่ใช่ทุกก้าว (เปลือง) และไม่ใช่เฉพาะตอนจบ (สายเกินไปเมื่อพัง)
อีกสองอย่างที่ต้องตั้งไว้ล่วงหน้าเสมอคือ เพดานงบ (เวลา เงิน จำนวนรอบ) และ เงื่อนไขหยุด ที่ชัดกว่าคำว่าทำจนกว่าจะเสร็จ agent ที่ไม่มีเพดานสามารถเผางบทั้งสัปดาห์หมดในบ่ายเดียวได้อย่างเงียบเชียบ และคุณจะรู้ตอนบิลมา
วัดให้ได้ว่าดีขึ้นจริง ไม่ใช่รู้สึกว่าดีขึ้น
ชั้นสุดท้ายคือชั้นที่แยกทีมที่ปรับปรุง agent ได้อย่างเป็นระบบ ออกจากทีมที่แก้ไปเรื่อย ๆ ตามความรู้สึก และมันเริ่มจากนิสัยเดียว: อ่าน transcript ไม่ใช่ดูแค่ผ่านหรือไม่ผ่าน
เหตุผลคือคำตอบสุดท้ายที่ถูกไม่ได้แปลว่าทางเดินถูก agent อาจได้คำตอบถูกด้วยวิธีที่เปราะมาก เช่นเดาถูกพอดี หรือข้ามขั้นที่ควรตรวจสอบ ในทางกลับกัน คำตอบที่ผิดก็ผิดได้คนละแบบ ตอนเราเทสโมเดลสามรุ่นกับงานเดียวกันใน workshop เทียบโมเดล สิ่งที่เห็นชัดคือรุ่นเล็กที่สุดไม่ได้ผิดแบบเอะอะให้จับได้ง่าย แต่ผิดแบบเนียนจนถ้าไม่ไล่ดูรายละเอียดก็นึกว่าใช้ได้ การวัดที่ดูแค่ถูกหรือผิดจึงมองไม่เห็นความต่างที่สำคัญที่สุด
สิ่งที่ควรเก็บให้ตอบได้ทุกครั้งที่ agent ทำงานหนึ่งรอบมีแค่ไม่กี่อย่าง: มันตัดสินใจอะไรบ้าง เรียกเครื่องมือไหนด้วยพารามิเตอร์อะไร เครื่องมือตอบกลับว่าอะไร ใช้ token ไปเท่าไร และจบด้วยเหตุผลอะไร แค่นี้ก็เปลี่ยนคำถาม “ทำไมมันทำแบบนั้น” จากการเดา เป็นการเปิดดูได้
เวลาเปลี่ยนอะไรในบังเหียน ให้ถามตัวเองข้อเดียวว่า ถ้าการแก้นี้ทำให้แย่ลง เราจะรู้ได้ยังไงและรู้เมื่อไร ถ้าตอบไม่ได้ แปลว่ายังไม่ได้แก้ แค่ขยับของไปมา
เริ่มจากตรงไหน ถ้ามี agent ใช้อยู่แล้ว
ไม่ต้องสร้างครบทุกชั้นตั้งแต่วันแรก งานภายในเล็ก ๆ ที่พังแล้วแค่เสียเวลา ไม่ต้องการบังเหียนหนาเท่างานที่แตะเงินหรือข้อมูลลูกค้า บังเหียนที่หนาเกินงานก็มีต้นทุนทั้งเวลาสร้างและความหน่วงตอนรัน
วิธีที่ได้ผลคือเอา agent ที่ใช้อยู่ตอนนี้มาไล่ถามตัวเองสั้น ๆ ว่า ถ้ามันพลาดแรงที่สุดตอนตีสาม ความเสียหายหยุดอยู่ตรงไหน, มีไฟล์กฎที่โตจากความผิดพลาดจริงหรือยัง, เครื่องมือที่มันเรียกบอกทางต่อตอนพังไหม, มีเพดานงบกับจุดหยุดหรือเปล่า, และพรุ่งนี้เช้าคุณเปิดดูได้ไหมว่าเมื่อคืนมันตัดสินใจอะไรไปบ้าง ข้อที่ตอบไม่ได้คือข้อที่ควรทำก่อน
มุมที่อยากให้เอาไปคิดต่อคือ ทักษะที่กำลังมีค่าขึ้นเรื่อย ๆ ไม่ใช่การไล่ตามโมเดลใหม่ทุกสัปดาห์ แต่คือการมองระบบรอบโมเดลให้ออกว่าตรงไหนหลวม ซึ่งเป็นงานออกแบบสถาปัตยกรรมล้วน ๆ และเป็นของที่โมเดลรุ่นหน้าไม่ได้มาแทนให้ เพราะทุกคนเช่าโมเดลตัวเดียวกันได้ แต่บังเหียนที่พอดีกับงานของคุณ มีคุณคนเดียวที่สร้างได้